2026年10月20日星期二

日子是点点滴滴攒起来的

最近把 TinyAi 挂上线了:https://tinyai.easyopen.work/

先说个场景。孩子第一次自己骑车,你在后面跟着,拍了张照,回家在群里说了句”今天他自己骑了两圈”。两年后再想找,照片还在,那句话翻不到了。

日子里的东西大多是这样丢的。没什么大事,多是零碎的一句、一张截图、一个转来的链接。当时觉得记得住,过一阵就没了。

为什么自己做

动手之前我看过一些同类工具,大部分是给办公用的:记会议、管项目、整理资料。我想找的是能记自己生活和心情的东西,一直没找到合适的,就自己做了。

TinyAi 就是替人记这些的。你只管过日子,剩下的它来。

怎么用

不用学。相册里出现新截图,它自己收;微信里把链接、图片、一段话分享过去,它回一句”收下了”;懒得打字就按住说话,松手发出去。

不用分类,不用起标题,不用想放在哪。丢进去就行。

零碎的东西会被串起来

收进去的东西按日子排好。截图里有日期和数字,它会顺手排个提醒:体检单上写着身高 132 厘米、明年 4 月复查,到了明年 4 月它会叫你。

每天晚上它写一页日记,用你的口气把当天的事连起来。哪句拿不准,点一下就能回到当时的原话。

想找什么直接问。”去年这时候孩子多高””老王推荐的那家店叫什么”,它把相关的几条翻出来,答案下面带着来源,能点回原件。它不编答案,只把你留下的东西找出来。

只给家里人用

TinyAi 不开放注册,只能拿邀请码进。一家人各用各的本子,想让谁看再给谁看。

原件的截图、录音、链接它不动,只写自己那部分;写错了能撤回,每处改动都追得到出处。不接广告,不卖数据,不拿记录去训练模型,也不做陌生人社区。

它不是给所有人用的产品,是给一家人用的一本本子。

现在

回看和把一年做成一本书还在做,日记的口气也时好时坏。不过”记得住、找得到”这件事已经能用了。

想试试的,找已经在用的家人朋友要一个邀请码。

https://tinyai.easyopen.work/

2026年9月18日星期五

在一间黑屋子里醒来:一个游戏故事可以怎么讲

前几天翻到 A Dark Room 的源码仓库,顺手 clone 下来读了一遍。八千行 JavaScript,没有框架,没有构建,连测试都没有。

但我读完之后坐在那儿愣了一会儿。让我惊叹的不是剧情有多曲折——它的剧情用三句话就能说完——而是它讲故事的方式。这些年玩过的游戏里,真正让我停下来想”这怎么做到的”的,没几个。

下面会把整个故事复述一遍。不想被剧透的,到此为止。

它做对了什么

从一个按钮开始

游戏打开的时候,屏幕上什么都没有。没有菜单,没有主界面,没有教程,没有”新游戏/读取/设置”。

只有一行字:生火。

我现在觉得这是整个游戏最重要的一个设计决定。它把”给玩家看什么”这件事压缩到了极限——不是”尽量少”,是真的只有一个。你不需要理解任何东西,你只能做一件事,所以你做了。

对比一下现在大部分游戏的开场:一段过场动画交代世界观,一个引导 NPC 告诉你你是谁,一排还是灰色的技能树暗示你以后能变多强。全都在拼命告诉你”这个世界很大”。

A Dark Room 反过来:它先让世界小到只剩一个按钮,然后让它自己长大。

界面自己会讲故事

点下”生火”之后,页面标题变了。从「一间黑屋子」变成「一间有火光的屋子」。

游戏的名字就是它的初始状态。而你做的第一件事,就把这个名字改掉了。

后来解锁了外面,那个页签叫「一片寂静的森林」。随着人搬进来,它一路变成:一间孤零零的小屋、一个小村子、一个不小的村子、一个很大的村子、一个喧闹的村庄。

从头到尾,没有任何一句话告诉我”你的村子变大了”。我是看着那行字自己变的。

同理还有那些按钮。屋子里一开始只有”生火”,后来多出”添柴”,多出建造栏,多出制作栏,多出交易栏,多出武器栏。它们不是先隐藏再显示,是真的一个一个被创建出来的。

代码层面它就是这么做的——所有场景的 DOM 摆在一条横轴上,解锁一样东西就往里 append 一个节点。那个标志性的横向滑动切场景的效果,不是转场动画,它就是布局本身。

所以”这个世界在你手里一点点长出来”这个体验,不是特效,是架构直接产生的。

这一条我觉得最值得偷:能让界面承担的叙事,就别写成文字。

让玩家先做,再告诉他做了什么

那个冻僵的女人被你烤火救活,站起来说她会造东西。然后游戏做了一件很轻的事:给她加了一条产出,每十秒 +2 木头。

一个快冻死的人,变成了一个数字。

后面整个村庄都是这个模式。人不断搬进来——“一支车队踉跄着开进来,满载着忧虑,也满载着希望”——然后我打开面板,把他们一个个拖进工种:猎人、制革匠、熏肉匠、铁矿工、炼钢工。

村子会着火,屋里的人会死光。会闹瘟疫。我每次看一眼,确认产出没掉太多,接着点。

游戏从来没有说过一句”你在剥削他们”。它只是让我亲手把人变成了产出条目,做了几百遍。

最狠的是抓到小偷那一段。两个按钮:吊死他,放他走。

吊死他,被偷的东西一件不少还回来。放他走,他谢你,教你一点技巧。

没有评论,没有道德条,没有后续惩罚。它只是让”对的那个选择”在账面上亏一点。

**玩家做的动作本身就是论点,文本只负责在最后给这些动作命名。**这是游戏这个媒介独有的能力,但用得好的少见——大部分游戏的做法是让 NPC 站出来发表一段演讲,告诉你战争不好。

真相藏在形容词里

这是我最服的一点。

A Dark Room 的反转——你不是幸存者,你是殖民者——没有任何一个揭示场景。没有过场动画,没有 NPC 突然摊牌,没有一段藏在角落里的日志把一切说清楚。

它是几个词,出现在了不该出现的位置。

地图最边缘有一艘坠毁的飞船,是通关的钥匙。走到跟前,游戏说:

一艘流浪者飞船那熟悉的曲线,从尘土和灰烬里浮现出来。
幸好这些土著不会操作里面的机械。

两个词。

「熟悉的」——一艘外星飞船的轮廓,为什么对我来说是熟悉的。

「土著」——那些我收留、分配、指挥、保护的村民,在叙述者的词汇表里,叫土著。

而叙述者一直是我。

还有一处,拿到一台外星制造机的时候,提示是:「流浪者机械重新运转起来的那种熟悉的嗡鸣。终于有真家伙了。」

「终于」。在这之前我一直在用骨头和石头凑合。

还有我仓库里一路小心囤着的东西,名字叫「外星合金」。对谁而言是外星的?对村民。对我不是。

这些词全都出现在纯功能性的句子里。你完全可以读过去不当回事——我第一遍就是这么读过去的。但一旦对上了一个,剩下的全都跟着炸开。

**把真相放在形容词里,不要放在情节里。**情节是作者告诉你的,形容词是你自己发现的。发现的东西才留得住。

铺垫多长,反转就有多重

前三十分钟是纯粹的放置游戏多巴胺。数字涨,按钮解锁,页签变多。我完全没在想剧情,我在想下一个建筑还差多少木头。

等我终于停下来读那句「幸好这些土著不会操作里面的机械」的时候,我已经为这台机器投了两个小时进去。

反转的力量不来自那句话,来自我自己的沉没成本。

这是很多游戏搞反的地方。它们把反转当成一个信息——只要信息够劲爆就够了,所以急着抖出来。但反转的重量其实取决于玩家在反转之前投入了多少、认同了多少、自我说服了多少。

A Dark Room 用两个小时让你确信自己是个好人:你救了濒死的陌生人,你收留了流浪的家庭,你保护村子不被野兽袭击,你为他们打下了矿井。

然后它用一个形容词把这两个小时全部重新解释了一遍。

最重要的那段,允许你错过

地图上有一片沼泽。要用村民手工做的护身符才能触发,而那玩意儿在商店里能卖钱,绝大多数人会直接卖掉。

沼泽深处一间长满苔藓的木屋,坐着一个入定的老流浪者。他说:

他曾经率领庞大的舰队,开往一个又一个新世界。
为了喂饱流浪者的饥渴,带来无可估量的毁灭。
他如今待在这里,是在赎罪。

这是全游戏把背景说得最白的一段。而它是可选的,隐藏的,要花钱的,很多人玩通关也没见过。

正常的产品思路是:这么重要的信息必须保证每个玩家都看到,得放进主线。

但 A Dark Room 的判断是:**玩家自己拼出来的结论,比被告知的结论牢十倍。**所以它宁可让一部分人永远拼不出来,也不肯直接说。

我觉得这是对的。那些被塞进必经之路的”重要设定”,玩家读的时候是在被动接收;而我为了一个护身符绕路进沼泽读到这段,那种感觉完全不一样。

连存档机制都算叙事

通关之后,存档被删了。

然后下一局开始,地图上多了一个上一局没有的地标:一座被毁的村庄。

一座被毁的村庄躺在尘土里。焦黑的尸体铺满地面。

空气里悬着流浪者飞船尾焰的金属味。

走进去,废墟中央的棚屋里还有补给。拿了:

前一代人的全部劳作都在这里。正等着被摘走。

翻源码确认过,这个地标只在有上一局存档时才会被注册进地图,而且捡到的每一样东西,都是上一局自己攒下来的。

也就是说:上一次我起飞的时候,用引擎的尾焰把那个村子烧掉了。

那些焦尸是救过我、养过我、给我挖矿炼钢、给我做那个护身符的人。而我这一局,正在做一模一样的事。

新周目继承是个纯系统性的设计,本来和剧情无关——大多数游戏就是”带点资源进下一周目,鼓励你重玩”。A Dark Room 把它变成了整个主题的最后一块拼图。

**存档、重玩、分数、成就,这些通常被当成”游戏系统”的东西,也是叙事资源。**而且因为玩家从不设防,它们打人更疼。

越努力,结局越惨

大部分游戏的结构是:做得越好,结局越好。支线做满,好感度刷够,解锁真结局,大家都活下来。

A Dark Room 反着来。

普通结局:你什么都不知道地飞走了,算是逃出生天。

而如果你走到地图另一个角落,打穿那艘坠毁的战舰,杀掉最后那个东西,拿到舰队信标再起飞,通关动画后面会多出四行字:

信标亮起一片纯蓝,然后暗了下去。飞船慢了下来。
渐渐地,庞大的流浪者母舰队出现在视野里。
巨大的世界舰在残骸云里不自然地漂着,伤痕累累,全都死了。

空气快没了。

座舱很冷。

然后整个屏幕上只剩下一个按钮。只有一个:等。

你毁掉一整颗星球,烧掉一个村子,杀穿一艘战舰,全都是为了回家。家早就没了。而你能做的最后一件事,是等。

探索的奖励是失去希望。

这需要很大的胆子。它等于告诉玩家:你在我这儿越投入,我给你的东西越难受。但正因为这样,那个”等”字才有分量——它不是叙事上的一个转折,它是对你这几个小时的总结。

它也有讲砸的地方

不吹成完美。

**中后期密度掉得厉害。**开荒地图那段文本量爆炸,但有效叙事被稀释了。大量地标就是纯战利品,没有任何剧情,翻开就是一个列表。前四幕那种”每一句话都在推进”的密度撑不住那么大的地图。

**战舰那条线和主线不是一个语气。**它是资料片移植过来的,单独一个文件,比主线所有事件加起来还长。动作场面多,留白少,写得挺好,但你能明显感觉到执笔的人和前面不是同一种呼吸。前面是”火在燃烧”,后面是”一个不稳定的自动机嗡嗡启动”。

**反转之后有点后继乏力。**真相对上之后,剩下的流程基本就是攒资源修船,故事没有再往前走一步。它把全部的力气压在了一个点上,这个点炸得非常响,但后面接不住。

第三条我觉得是最难避免的——单点反转型的故事都有这个问题。要解决就得让反转之后玩家的行为发生变化,但那意味着重做一套系统。

完整的故事

下面是从头到尾的复述。

一

你醒了。头疼,眼前模糊。屋子是黑的,很冷。

屏幕上只有一句话:生火。

你点了。火起来了。

火会灭,木头会烧完。你出门捡柴,回来添火,再出门捡柴。左边的通知一行一行浮上来又淡掉。

风在外面呼啸。
木头快没了。

然后某个晚上,门被撞开了。

一个衣衫褴褛的陌生人跌进门来,倒在角落里。

她在发抖。你往火里加柴。

陌生人打着哆嗦,小声嘟囔着什么。听不清她在说什么。

你继续加柴。

角落里的陌生人不抖了。她的呼吸平缓下来。

再过一会儿,她站起来了。

陌生人站在火边。她说她能帮忙。说她会造东西。

从这一刻起,你的木头每十秒 +2。

二

她给你搭了捕兽夹,夹子里有毛皮和肉。有东西可以换,就开始有人来。

夜里来了个陌生人。
一户风尘仆仆的人家住进了其中一间小屋。
一支车队踉跄着开进来,满载着忧虑,也满载着希望。

森林变成小屋,小屋变成村子,村子越来越大。

你打开面板,把他们一个个拖进工种里。那支满怀希望的车队,变成了每十秒结算一次的数字。

村子会出事。小屋会烧掉,屋里的人全死。会闹瘟疫。捕兽夹会被撕烂。你每次看一眼,确认产出没掉太多,接着点。

有一天村民从仓库里拖出一个人。

村民们从储藏室里拖出一个满身污垢的男人。
说他那伙人一直在偷补给。
说应该把他吊起来,杀一儆百。

吊死他,还是放他走。

三

后来有个游商卖给你一个旧指南针,地图就打开了。

六十一乘六十一的字符网格,村子在正中央,是唯一的一个 A。往外是森林、草原、荒原、废墟、矿井、洞穴、城镇。越远越要命。

带上熏肉和水出门,走几步吃一口,走几步喝一口,吃完就得回头,不然死在路上。

然后开始杀东西。一开始是野兽,后来是人。

一个瘦削的男人走过来,眼神疯狂。
一个拾荒者凑上来,想捡个便宜。

再后来是有组织的军队。铁矿煤矿硫磺矿全被军队占着,一个个打下来。

军队已被清除。矿井现在对工人是安全的了。

你闯空屋子,闯废弃的城镇,闯倒塌的城市,撬柜子翻尸体。在某座城市里你放了一把火:

那个小定居点显然已经烧了一阵子了。
住在这里的流浪者的尸体还在火里看得见。
还来得及抢救一点补给。

四

地图外圈有一些巨大的坑。

一个巨大的洞被深深切进地里,是上一次收割留下的证据。
他们拿走了想要的东西,然后走了。

地图最边缘有一艘坠毁的飞船。

一艘流浪者飞船那熟悉的曲线,从尘土和灰烬里浮现出来。
幸好这些土著不会操作里面的机械。

沼泽深处有个入定的老流浪者。

他说他曾经率领庞大的舰队,开往一个又一个新世界。
为了喂饱流浪者的饥渴,带来无可估量的毁灭。
他如今待在这里,是在赎罪。

而你仓库里一路囤着的东西,名字叫「外星合金」。

于是全部对上了。

流浪者是一个跑遍星海的掠夺文明。舰队开到一颗星球,抽干,离开,换下一颗。这颗星球已经被收割过一次了,那些巨坑就是上次留下的。

你是一个坠机后失忆的流浪者。醒在一间黑屋子里,救活一个土著女人,靠她起家,把整个土著社会改造成一台采掘机器,屠光一切挡路的原住民,只为了凑够零件修好一艘船飞走。

黑屋子里那个冻得发抖、需要被救的可怜人,从头到尾都不是你。

五

船修好,加固船体,升级引擎。起飞前游戏只问一句:

该离开这个地方了。不会再回来了。

起飞。躲过小行星带。冲出大气层。

通关。存档删除。

六

但没有全删。

下一局,又醒在一间黑屋子里。又是火,又是木头,又是那个跌进门来的陌生人。

只是地图上多了一座被毁的村庄。

一座被毁的村庄躺在尘土里。焦黑的尸体铺满地面。

空气里悬着流浪者飞船尾焰的金属味。

废墟中央的棚屋里还有补给。拿了。

前一代人的全部劳作都在这里。正等着被摘走。

你捡到的每一样东西,都是上一局你自己攒下来的。

七

地图另一个角落有一艘垂直插进地里的巨舰。

里面是一整座竖着的死城。船壳、工程舱、医疗舱、训练场、指挥甲板,一层层往上。

人类的军队在里面扎了营,墙上有粗糙的切割痕迹,地上散落着铜线碎屑——土著在笨拙地拆解你的科技,换几根铜丝。

从实验室跑出来的变异生物,收容舱全开着。

还有一直在待机的自动防御:

自动守卫仍在走廊里巡逻,浑然不知它们的主人早已离开。

船是怎么毁的,没人说。但一层层走上去,会发现路障的朝向不对:

这里没有发生过战斗。
看样子他们想用路障把电梯堵住。

船员在堵电梯。敌人在船里面。

指挥甲板上空无一人,只有正中央坐着一个矮小的身影:

流浪者的形态,但不太像血肉。也不太像金属。胸口嵌着一块水晶,脉动着光。
它说它早就预见了那场叛乱。说它做了安排。

打死它,掉一样东西:舰队信标。

八

带着信标起飞。

信标在轻轻搏动,飞船滑行在太空里。坐标已经锁定。什么也不用做,只要等。

信标亮起一片纯蓝,然后暗了下去。飞船慢了下来。
渐渐地,庞大的流浪者母舰队出现在视野里。
巨大的世界舰在残骸云里不自然地漂着,伤痕累累,全都死了。

空气快没了。

座舱很冷。

屏幕上只剩下一个按钮:

等。

按下去,画面淡出,分数出现,下面一行小字:重新开始。

后面

我把这些拆出来,不是想总结出一套方法论。这游戏很大程度上是不可复制的——它的极简是被”纯文字网页游戏”这个形式逼出来的,而那个形式本身在 2013 年是个异类。

但有两条我觉得是通用的。

一条是让玩家先做,再告诉他做了什么。游戏能做到而小说电影做不到的,就是让观众成为共犯。大部分游戏浪费了这个,还在用过场动画讲道理。

另一条是忍住不解释。把最关键的信息放进一个形容词,放进一个可选的支线,放进一个玩家从不设防的系统机制里。相信玩家自己能拼出来,也接受一部分人永远拼不出来。

代码那边还有一堆东西可以写——它怎么用五十行写出一个手搓的 Redux,怎么用”黏性概率”生成一张不像噪点的地图,怎么把十三万字符的剧情做成纯数据让非程序员也能写。留到下一篇。

项目地址:https://github.com/doublespeakgames/adarkroom,MPL-2.0。想直接玩的话:https://adarkroom.doublespeakgames.com

2026年8月20日星期四

从结构上理解 tmux

最近用 Google NotebookLM 整理了一套讲 tmux 的幻灯片,15 页。大多数教程上来就让你背快捷键,能照抄,但过两周就忘。这套先把 tmux 的结构和设计讲清楚,键位反而变成顺理成章的东西。

三个设计出发点

tmux 到底解决了什么,就三件事:

  • 持久化:终端关了,会话还在。SSH 断线不用重来。
  • 多路复用:一个终端里开一堆 shell。
  • 可移植:~/.tmux.conf 一搬,换个机器手感一样。

四层结构

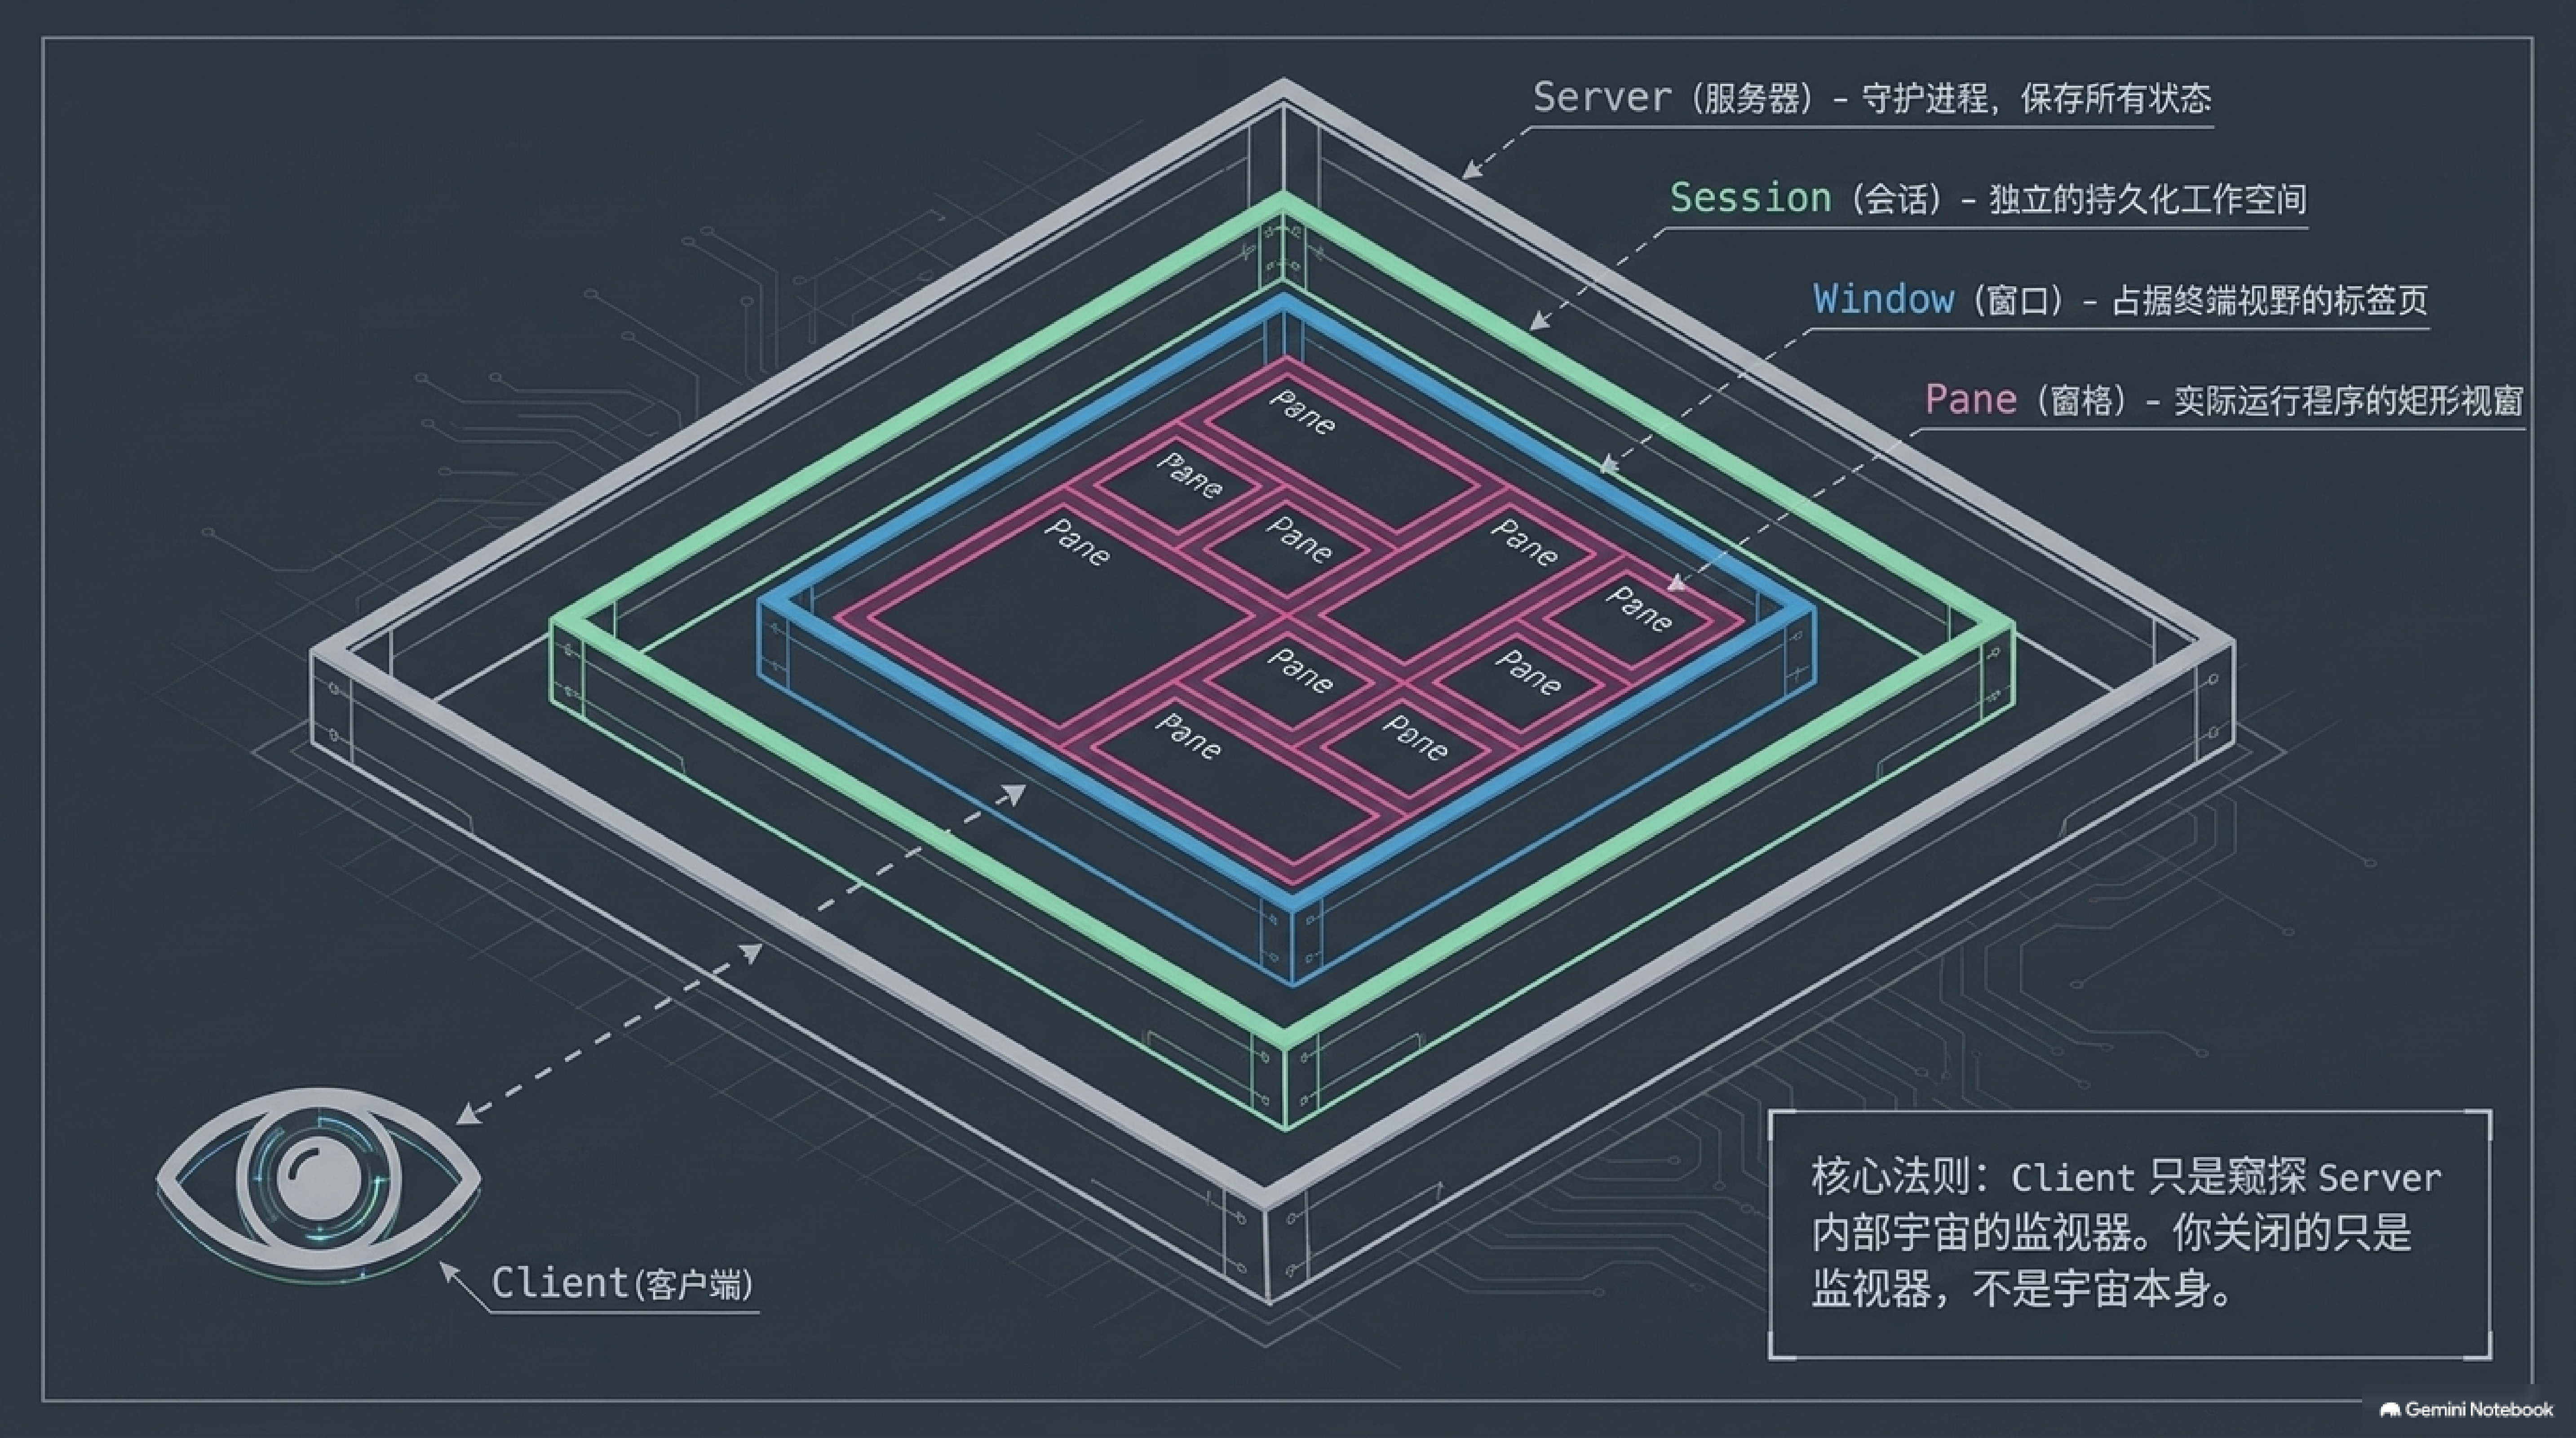
tmux 的一切都建立在这四层上:Server → Session → Window → Pane。

  • Server:本机只跑一个后台进程,所有会话都挂在它下面。
  • Session:一次工作区,通常一个 SSH 连接对应一个会话。
  • Window:会话里的标签页。
  • Pane:窗口里切成的一块块,每块是独立的 shell。

Client 和 Server 分离

这是整套设计的核心。终端窗口只是个 client,真正的状态都在 Server 上,client 断掉、重连,Server 照跑。持久化就是这么来的。

前缀键

tmux 接管了终端之后,得区分”这个按键给 shell 还是给 tmux”,于是有了 Prefix(默认 Ctrl+b):先按前缀打招呼,再说正事。理解了这一点,键位就全不用背了。

操作天然对得上层级:

  • Pane:Prefix + % 竖切," 横切,方向键切换,x 关掉
  • Window:Prefix + c 新建,0-9 切换,p/n 前后
  • Session:Prefix + d 分离,s 打开会话树

复制模式

Prefix + [ 进入复制模式,用 Vim 键位上下翻、选、复制。tmux 自己维护屏幕缓冲区,复制也得过它一道。

自己绑键

Ctrl+b 两级有点慢,很多人把常用的直接绑到 Alt 上,Alt+1 切窗口、Alt+方向键 切窗格。这就是 bind -T root 干的事——在不按前缀时直接响应。配合 if-shell 和 Format 还能做条件绑定,比如只有左边还有窗格时才往左移。

状态栏

status-left / status-right 可以放文本、颜色,甚至嵌入 shell 命令的输出(uptime 之类),status-interval 控制刷新频率。状态栏其实是块可编程区域。

进阶玩法

幻灯片最后列了一批:SSH Armor(SSH 断了会话不丢)、Session Resurrect(重启后恢复会话)、Pane 边框高亮、快速调整大小。都是在四层结构上做文章。

对我来说最有价值的其实是那四层结构。之前记不住键位,就是因为不知道它们挂在哪个层级下面;结构清楚了,键位自己就记住了。

附:这套幻灯片 PDF 原件(15MB)可以在这里下载。

2026年8月9日星期日

给 coding agent 建个 brain 目录:工作区与代码分离

题图:Alexa Williams via Unsplash

让 coding agent 同时管好几个微服务后端加一个前端,最麻烦的是上下文散在各仓库里。摸索了几个月,我现在的做法是给 agent 单独建一个工作目录,再配合 worktree 做任务隔离。写完发现别人也有类似思路,一起整理进来。

一开始的问题

最早我是直接在项目仓库根目录启动 agent 的。仓库里塞了 CLAUDE.md、skills、各种记忆文件,一开始挺顺,但项目一多就乱套:

  • 每个仓库都要单独配一遍 skill,换个项目就要重复劳动
  • agent 的知识和记忆跟着单个仓库走,跨仓库的上下文完全接不上
  • 改一个项目的时候,agent 读到的”全局约定”和这个项目的”本地约定”混在一起,分不清

一个典型的项目往往是好几个微服务后端加上一个前端,仓库本来就是拆开的。让 agent 陷在某个子仓库里,等于把它的视野锁死在局部。

现在的结构:把工作区从代码里拆出来

做法很简单,给整个项目单独建一个 agent 的工作目录,叫 brain,和代码仓库平级:

1
2
3
4
5
6
7
8
9
projectA/
├── brain/ # agent 的家
│ ├── .claude/ # 原样兼容 Claude Code
│ │ └── skills/ # 所有 skill 放这
│ └── CLAUDE.md # 项目级约定
├── repo1/ # 微服务后端
├── repo2/
├── repo3/
└── frontend/ # 前端

agent 启动的时候 cd 到 brain/,而不是任何一个仓库里。

brain 目录里放什么

我遵循一个原则:能直接用 Claude Code 原生的,就不自己发明格式。所以 brain/ 里第一个东西就是 .claude/ 目录,里面按 CC 的规范放 skills。这样 agent 一启动就自动识别这些 skill,不需要任何适配层。

CLAUDE.md 放在 brain/ 的根下,写的是这个项目所有仓库共用的约定——目录结构、工作流、注意事项。单独的项目有自己的规矩,就写在它自己仓库的 CLAUDE.md 里。职责分两层:

  • brain/CLAUDE.md:跨仓库的全局约定
  • 各仓库 CLAUDE.md:仓库局部的约定

这样做的好处是 agent 启动后先读全局约定,建立起整个项目的地图,再按任务进到具体仓库。

后来我在网上看到,Karun Japhet 的《Structuring Claude Code for Multi-Repo Workspaces》也做了类似的分离。他的做法是把 workspace 根目录本身当做一个不装代码的 bootstrap repo,里面放 repo manifest 和分层 CLAUDE.md(组织级、团队级、仓库级),其他仓库被 gitignore 掉、由 repo manager 克隆进去。Claude Code 会沿着目录树向上找 CLAUDE.md,所以从任何一个子仓库启动,都能叠加读到所有层级的约定。

跟我的 brain/ 有个区别:他的 bootstrap repo 是父目录,所有仓库都装在里面;我的 brain/ 是平级目录,和仓库并排放。父目录方案适合整个公司/团队共享一套上下文的场景,平级方案更轻,一个项目一套,互不干扰。

用 worktrees 做任务隔离

工作区分离解决的是”上下文”问题,任务隔离解决的是”互相污染”问题。同一个仓库,agent 做任务 A 时改了文件,任务 B 接着做,两边就打架了。

我的做法是用 git worktrees 给每个任务开一个独立工作区:

1
2
3
4
5
6
7
projectA/
├── brain/
├── repo1/
├── worktrees/ # 任务隔离区
│ └── task1/
│ ├── repo1
│ └── frontend

每个任务一个 worktrees/task1/ 目录,里面按需要 checkout 相关的仓库。任务做完了整体合并、丢弃都干净,不会污染主工作区。

这块我写了一个 skill 来自动维护,不用每次手动敲 git 命令。skill 负责建 worktree、把对应仓库 checkout 过去、记录任务和 worktree 的对应关系。agent 接到任务时,先问 skill 要个新 worktree,任务结束后再让它收尾。人只需要描述任务,不用管 worktree 具体怎么建。

查资料的时候发现,Claude Code 现在其实内置了 worktree 支持:claude --worktree <name> 会在 .claude/worktrees/ 下建一个隔离的工作区,还可以用 .worktreeinclude 把 .env 这类被 gitignore 的文件自动带进新 worktree,subagent 也能通过 isolation: worktree 单独隔离。

但我没直接用内置的这套,因为默认目录在仓库里。.claude/worktrees/ 建在仓库内部,有几个问题:

  • 它跟着单个仓库走,一个任务要同时动多个仓库(比如改一个后端加前端),内置方案管不过来
  • worktree 的状态文件落在仓库里,会污染仓库本身,还得靠 .gitignore 兜着
  • 任务隔离区的语义不清晰,.claude/worktrees/ 里混着各任务的 worktree,时间一长分不清哪个是哪个

我写 skill 的目的,就是解决这个默认目录的问题:把 worktree 统一挪到项目顶层,按任务归组,不放进任何单个仓库里。

learn-claude-code 项目里有一节专门讲”任务和 worktree 绑定”,我看了它的源码,机制和我的 skill 是一个思路。它把状态拆成两个面:

  • 控制面(task):管目标。一个 task 有 id、状态(pending → in_progress → completed),还有绑定的 worktree 名
  • 执行面(worktree):管目录。一个 worktree 有名字、路径、分支(wt/<name>)、归属的 task_id

关键在绑定这一步:建 worktree 时传 task_id,系统会做三件事——git worktree add -b wt/auth-refactor .worktrees/auth-refactor HEAD 建目录、往 worktree 索引里写一条带 task_id 的记录、把 task 状态从 pending 推进到 in_progress。收尾时 worktree_remove(name, complete_task=True),删掉 worktree 的同时把绑定的 task 标记为 completed 并解绑,一步搞定清理和完结。

它把事件流也记下来了:每次 create/remove/keep 都往 events.jsonl 里追加一条,崩溃之后可以从 .tasks/ 和 worktree 索引重建状态,不用靠对话记忆。这个设计比我 skill 里的纯对应关系记录更完整,值得抄。

不过有个差异:它是单仓库的方案,worktree 建在仓库自己的 .worktrees/ 下;我这边 worktree 是项目顶层、按任务归组、跨仓库的,所以只能自己维护,不能直接复用它的代码。机制可以参考,目录布局得按自己的场景来。

brain 会自己进化

这个结构跑通之后,最意外的收获是 brain/ 变成了一个会生长的东西。日常使用中,agent 在任务里发现的规律、踩过的坑、验证过的做法,会沉淀下来:

  • 一个坑踩了两次,就把它写成一个 skill,下次直接复用
  • 某类任务的固定步骤,整理成工作流文档放进 CLAUDE.md
  • 跨仓库共用的知识,从某个仓库的局部经验升级到 brain/

也就是说,brain/ 不只是配置文件,它是我和 agent 一起维护的知识库。agent 在任务里产生知识,人负责整理和把关,把散的经验固化成可复用的能力。这个目录越用越厚,agent 也越用越顺手。

维护时我给自己定了一条规矩:每条规则都来自一次真实的踩坑,没真实出现过的问题不写。这样 brain 里没有想当然的假设,每一条都是验证过的。

一些实际的体会

  • 先问清楚再动工。 任务开始前让 agent 先读 brain/CLAUDE.md,把项目结构说一遍,确认理解对了再干活,比直接让它改代码稳。
  • worktree 的生命周期要盯。 skill 建了 worktree,但任务结束没人合并的话,会越积越多,隔段时间清理一下。
  • 别什么都往 brain 塞。 只放跨仓库通用的东西,单仓库的琐碎约定放回它自己的 CLAUDE.md,否则 brain 很快会变成一锅粥。
  • 别开太多并行任务。 网上普遍的结论是两三个并行的会话是甜点区,开十个的话,光是审合并就够你忙的。

这套东西没什么新发明,就是把”工作区和代码分开”这种工程上常用的思路,搬到了 agent 身上。agent 的上下文管理,跟人的项目管理一样,讲究的也是职责分离和清晰的边界。

参考

2026年8月8日星期六

哪个 coding agent 最好用?看了一圈 GitHub 数据

题图:Steve A Johnson via Unsplash

前阵子有人在社区问”最强的 coding agent 是什么”,回复里提了一堆项目。我拿 GitHub 数据逐个查了一遍,把 star、fork、issue 数量和最近提交时间记了下来。结论放在最后。

大项目的数字

数据是 2026 年 8 月 8 日抓的,用 GitHub 的 API 和官方 CLI。第一梯队的几个:

项目 Star Forks Open Issues Contributors 最近提交
Hermes Agent 227,178 44,447 29,597 393 08-08
OpenCode 194,857 24,924 4,993 456 08-08
Claude Code 140,634 22,612 15,313 52 08-08
Codex 104,695 15,833 11,917 471 08-08
pi 85,376 10,593 94 263 08-07
Reasonix 32,950 2,124 948 126 08-08
Herdr 25,693 1,807 137 73 08-07
omp (oh-my-pi) 22,829 2,173 1,109 360 08-08

小一些的社区或个人项目:

项目 Star Contributors 最近提交
Orca 550 1 08-08
ccteam 139 4 08-02
OpenABCode 103 2 07-20
hyper-grok-build 64 6 08-07
zacp 7 1 08-07

看到的一些情况

Star 分成两档

前五个项目都过了 8 万,一个量级。Reasonix、Herdr、omp 在 2 万到 3 万,是第二档。中间空档挺明显的。

大部分还在持续提交

除了 OpenABCode 停在 7 月 20 号,其余项目最近一两天都还有提交。这个赛道现在还在抢位置的阶段,没有哪个敢停。

Claude Code 的数字看着像开源,其实不是

它的仓库只有 52 个 contributor,跟 Codex 的 471、OpenCode 的 456 差了一个数量级。它是闭源产品,仓库主要拿来收 issue、放路线图,不是真的开源协作。光看 star 容易误会。

Issue 数量差得很远

Hermes 有近 3 万个 open issue,Claude Code 和 Codex 也都过万。pi 只有 94 个,少得反常,可能是 issue 管得严,也可能是用户习惯去别处问。

小项目维护反而勤快

社区里反复被提的 ccteam、hyper-grok-build、zacp 都是个人作品,star 只有 7 到 139,但作者几乎每天都有提交。选 agent 看提交频率,比看 star 实在。

没找到开源仓库的几个

Fable、CommandCode、qoder、workbuddy、ampcode、zcode 这几个在 GitHub 上没有对应仓库,有的是商业产品,有的只在别处分发。

结论:哪个最好用?

头部的项目都还活着,还在更新,所以没有”选错了就没得用”的问题。

单看数据的话:代码能力、生态、社区反馈最均衡的是 OpenCode 和 Codex,前者全开源、issue 管得干净,后者有大厂背书、提交最勤。Hermes 的 star 最高但 issue 堆积严重,说明反馈多是多,响应未必跟得上。Claude Code 虽然好用,但闭源这点摆在那,真在乎可控性就得掂量。

真要选,与其纠结 star,不如看你常用的模型被哪个 harness 接得顺手,再看它最近的提交频率。

2026年8月1日星期六

给 agent 装个“小本本”:用 Learnings.md 记下踩过的坑

题图:Mike Tinnion via Unsplash

MindStudio 有篇文章讲怎么给 Claude Code skill 加一个 Learnings.md,让 agent 跨会话”长记性”。读完发现这跟我这几个月一直在做的几乎是同一件事,正好借这篇文章把思路捋清楚,顺便记下自己用下来的体会。

问题:skill 不会进步

Claude Code 每次开新会话都是”失忆”的。没有上一次运行的记忆,不知道上次什么做成了、什么失败了,也不记得三个星期前花二十分钟查过的一个 API 怪癖。

skill 是定义好、反复跑的工作流。单次任务这样没问题,但 skill 这种”隔三差五就跑一次”的东西,每次从零开始就亏了——它不是越用越好,而是全靠你手动补充上下文,看着它一遍遍重复同样的错误,然后你只能不断往系统提示词里塞笔记,最后堆成一堵墙。

核心做法:一个文件

思路很简单:一个 Learnings.md 放在项目里,Claude 开始任务前读它,任务结束后往里写新条目。下次运行,上一轮的经验就在上下文里了。没有数据库、没有向量检索,就一个文件。

这背后的原理不玄:Claude 不需要持久记忆,它需要的是”开工时能读到一份结构清晰的文件”。人写知识库也是一样——写下来就不靠记忆。区别在于这里 Claude 既读又写,而且配置好之后它能稳定地做这两件事。

用 markdown 也是对的:Claude 读写它没有额外负担,标题和列表提供结构,人能直接审阅和改,还能跟着代码一起进 git。

我自己怎么用的

文章里教的配置和我实际在做的差不多,我挑了觉得关键的几点说说。

会话前读、结束后写,两条都不能省

读这步容易做到,让 agent”真的用上”反而要下点功夫。文章提了个技巧:让 agent 开工前先把 Learnings.md 的内容总结成 3-5 条要点。光让它”读一下”它可能会扫过,但让它”总结”就逼着它真处理了内容。

写这步更难,因为 Claude 会把更新当成可选动作跳过。要写成无条件的:”结束会话前必须更新 Learnings.md,就算没发现新东西也要写一笔确认。”这样还能留审计痕迹——哪次跑了没产出、哪次有新发现,一目了然。

写”能用的”经验,别写废话

文章这句我特别认同:“Avoid relative imports in /utils — the build step resolves them incorrectly” 是有用的,“Be careful with imports” 不是。

下面这些基本没用:

  • 数据库层要小心
  • /legacy 的测试比较难搞
  • API 调用有时候行为出人意料

都没说清楚”小心什么”、”难在哪”、”什么叫出人意料”。Claude 没法照着行动,还白占上下文。

条目带个 confidence 分级(high/medium/low)也有用。低置信度的是”只遇到过一次的猜想”,高置信度的是”确立的规则”。不区分的话,Claude 没法判断该多坚定地执行某条规则。

文件要维护,会膨胀

这是个共享文档,Claude 往里加、你来删改,两边一起维护。每隔几周过一遍:把经过多轮验证的低置信度条目升级、删掉重构后已经失效的、重写 Claude 写得含糊的、加一些它自己发现不了的项目知识。

目标是一份”信号密集”的文件。30 行精准的条目比 200 行过时观察有用得多。

我踩过的坑

文章列的常见错误里,有三个我确实遇到过。

读了不等于用了。 光在 CLAUDE.md 里写”开工前读 Learnings.md”没用,agent 会假装读过。用总结那招强制它过一遍,效果立竿见影。

别拿它替代系统提示词。 Learnings.md 装的是”运行中发现的动态知识”,系统提示词和 CLAUDE.md 装的是”你决定的静态知识”。两者互补,不是替换。把该放系统提示词的指令塞进 Learnings.md,或者反过来,都会乱。

一个 skill 一个文件,别混。 同一仓库里跑多个不同工作流时,给各自开一个。混在一起,Django 的观察对 Next.js 的工作流就是噪音。

我对这个模式的看法

它其实不是新东西,就是”把隐性知识落成文件”这一套,只是这次读写双方换成了 agent。跟我在 Matt Pocock 的 skills 里看到的 CONTEXT.md 共享语言、还有我自己博客的 AGENTS.md,都是同一个思路:用文件给 agent 续上下文,而不是靠它自己记。文件会进 git、能被 review、能剪枝,这套工程纪律搬到 AI 上一样成立。

要说局限,文件是被动的,agent 写什么质量取决于它怎么理解和归纳,需要人定期盯。另外这种模式解决的是”跨会话记忆”,解决不了模型本身的推理上限——写满了不表示它就能做对。

链接

Matt Pocock 的 skills:把工程纪律塞进 AI 编码

题图:Chris Ried via Unsplash

Matt Pocock 大概是 TypeScript 圈最出名的”老师”之一,Total TypeScript 作者。前几天他把自己在 .agents 目录里用的 skills 全部开源了,叫 skills,我点进去的时候已经 198k stars,skills.sh 上显示 49 个 skill、累计安装量 1260 万次。这个量级在工具类仓库里相当夸张。

作者是谁

Matt Pocock,英国程序员,TypeScript 圈子的头部布道者。让他出名的主要是两件事:

  • Total TypeScript(totaltypescript.com):一套讲 TypeScript 的付费课程和免费内容。他在 Twitter/X 上常年发 TypeScript 进阶技巧,很多”看完恍然大悟”类型的梗图和类型体操都出自他,粉丝量在开发者里属于顶流。
  • Zod 等库的维护者:他维护过几个前端生态里常用的类型库,社区认可度很高。

这几年他基本全职在做内容和教育:录视频、写教程、维护 AI Hero(他聚焦 AI 编程的教育品牌),这个 skills 仓库就是 AI Hero 体系的落地。他的特点是不追花活,讲东西喜欢落到工程实践上——这跟这次开源的 skills 的风格是一致的。

它是什么

一句话:Matt 每天用 AI 写真实代码时加载的一组 skill 文件,直接从他个人的 agent 配置里拷出来的。封面写着 “Skills for Real Engineers”,副标题 “not vibe coding”。

现在市面上有很多帮 agent 工作流”接管过程”的方案,比如 GSD、BMAD、Spec-Kit。它们的问题是:过程被框架占死了,你想改也改不动,一旦框架本身有 bug 就很难排查。Matt 的选择是反过来——写一堆小、容易改、可以互相组合的 skill,每个 skill 就是一份 markdown 说明,告诉 agent 在某种情况下该怎么做。

核心的几个 skill

/grill-me 和 /grill-with-docs

这两个是他说的最受欢迎的 skill。核心动作是动手之前,逼 agent 反问你。

我们最常见的问题不是 agent 写不出代码,而是它”没搞懂你要什么”就开写。grill 的流程就是让 agent 扮演一个较真的面试官,把你计划里的每个分支都问一遍,直到它(和你)都确认没歧义了再开工。

这个 skill 的实际行为挺讲究,我看了它的实现:

  • 一次只问一个问题,等你答完再问下一个,避免一次抛一堆问题把人绕晕。
  • 每个问题都带一个推荐答案,不是空问。
  • 能查的事实不问你,原文是 “If a fact can be found by exploring the environment, look it up rather than asking me. The decisions, though, are mine”——该 agent 自己翻代码就能确认的事别浪费你时间,只有决策才需要你来拍板。

grill-with-docs 在追问之外会顺手产出一份 CONTEXT.md,记录这个项目里的”行话”。它在 skills.sh 上单 skill 安装量 61 万,仅次于 grill-me 的 72 万。

CONTEXT.md:共享语言

这是我觉得整个仓库里最妙的一个点。agent 刚进项目时不知道怎么称呼各种概念,于是用 20 个词解释本来 1 个词就能说清的东西。

他在示例里给了个对比:

BEFORE: “There’s a problem when a lesson inside a section of a course is made ‘real’ (i.e. given a spot in the file system)”
AFTER: “There’s a problem with the materialization cascade”

后者是你和 agent 共同维护的行话。好处不止省 token:变量、函数、文件名命名更一致,代码更好导航,agent 思考也更省力。这其实就是 DDD 里 ubiquitous language(通用语言)那套,搬给 AI 用。仓库里甚至有个 skill 直接就叫 ubiquitous-language。

CONTEXT.md 不是一句口号,是带约束的词汇表。拿仓库自己的 CONTEXT.md 举例,它对每个术语都写了”用这个词、别用那些词”:

Issue tracker:The tool that hosts a repo’s issues
Avoid: backlog manager, backlog backend, issue host

还专门留了一节 “Flagged ambiguities” 记录历史纠偏,比如之前 “backlog” 一词既指工具又指工作集合,现在统一拆成了 Issue tracker 和 Issue。这种文档就是给 agent 的唯一真相源,防止它每次自己发明叫法。

/tdd 和 /diagnosing-bugs

围绕”反馈循环”做的。agent 产出垃圾代码,很多时候是因为它在瞎写——不知道写出来的东西到底跑没跑起来。tdd skill 让 agent 先写一个会挂的测试,再让它过,红-绿-重构,把反馈节奏固定下来。

细节上它把”seam(接缝)”作为核心概念:测试只写在预先和用户确认过的公共接缝上,别碰内部实现。它还明确列了测试的反模式——水平切片(先把所有测试写完再写实现,测的是”想象中的行为”)、同义反复(断言用跟实现一样的方式重新算一遍期望值,永远不可能失败)。每一条都对应 agent 写测试时最常犯的错。debug 有专门的 diagnosing-bugs 循环:复现 → 最小化 → 假设 → 打点 → 修复 → 回归测试。

/improve-codebase-architecture

针对”一坨屎”的问题。agent 写代码太快,熵增也快,代码库很容易在几周内变成泥球。这个 skill 会扫描代码库、生成一份可视化的 HTML 报告,然后让你挑一处来做深度优化。作者建议每几天跑一次。

它的理论基础是 John Ousterhout《A Philosophy of Software Design》里的 shallow / deep modules(浅模块/深模块)——“好模块是深的,一小段接口后面藏着大量行为”。skill 会找出那些”接口和实现一样复杂”的浅模块,逐个给你列”深化机会”,每个候选配一张 before/after 示意图,最后用 deletion test 判断:删掉这个模块是把复杂度集中了,还是只是挪了个位置。选中的方案再走一遍 grill 流程细化,过程中新概念顺手写进 CONTEXT.md。

安装方式:两种哲学

安装有两条路,代表了两种心态:

  • Claude Code 插件:claude plugins install mattpocock-skills,装完整个集合作为一个只读的托管 bundle,作者更新你自动跟着更。你是在”订阅”。
  • skills.sh:npx skills@latest add mattpocock/skills,把 skill 文件直接拷进你项目里,随便改,改完归你。你是在”fork”。

作者自己的态度很明确:建议你 hack 这些文件,改成自己的。别把它当圣经。这也是整套东西的设计哲学——skills 是给你的起点,不是终点。

写 skill 本身也是门工程

翻仓库时最让我服气的是 writing-great-skills 这个 skill——它不是给人用的工具,而是教 agent 怎么写好 skill 的方法论。开头那句点题:

A skill exists to wrangle determinism out of a stochastic system.

skill 的存在是为了从随机的系统(模型)里挤出确定性。它不求每次输出一样,只求每次走同一个过程。围绕这个目标,它给了一整套写作纪律:

  • context load 预算:每个 skill 的 description 常驻在模型窗口里,多一个字都是成本。所以只有需要 agent 主动触发的 skill 才开放给模型调用(model-invoked),纯手工触发的一律禁掉,省下上下文。
  • leading words:用模型预训练里已有的概念词当锚点,比如把”快速、确定、低开销”压成一个词 tight,把”一个你信得过的循环”压成 red(变红=出 bug,一个布尔状态)。用最少的词唤醒模型已有的行为习惯。
  • 渐进披露:细节往下推到链接文件里,SKILL.md 顶部只留主干,需要时才展开。
  • 去 no-op、防 negation:删除”模型本来就会做”的废话(比如 be thorough 不如 relentless);不要用否定句式,因为”别想大象”反而会让它想到大象,要直接说该做什么。

这套东西把自己当成要维护的代码来写,有命名、有预算、有反模式。我之前一直觉得”skill 不就是一段提示词吗”,看完才意识到写好一段提示词跟写好一段代码是一回事。

另外它不只有工程 skills。49 个 skill 里有写文章的(writing-shape、writing-beats)、教东西的(teach)、做手记交接的(handoff)、甚至连 caveman 这种不正经名字的都有。这跟 Matt 现在的身份一致——他做内容、做教育,不纯写代码。

我的看法

这套东西本质上不是新发明,它是在把《程序员修炼之道》《领域驱动设计》《A Philosophy of Software Design》里那套老原则,翻译成 agent 能照着执行的动作。它火,不是因为创造了新概念,而是因为终于有人把”怎么跟 AI 协作”这件事,按工程方法而不是玄学来做了。1260 万次安装量也说明这不是自嗨,是真有人拿它干活。

说几个我觉得值得借鉴的点:

  1. 把隐性知识显性化。共享语言、ADRs、spec、tickets,都是把散落在对话里的决定落成文档。
  2. 过程可控。框架接管 vs 一堆可组合的小规则,后者的可调试性高一个量级。这也解释了我为什么一直对”全自动流程”持保留态度。
  3. 强调反馈。没有反馈的 agent 和没有测试的程序员一样,都是瞎写。

要说局限:这套 skill 是 Matt 给自己写的,针对他熟悉的 TS 技术栈和工程习惯,照搬不一定适合所有人。而且它默认 agent 有很强的推理能力,弱模型跑这套流程效果会打折扣。另外 skill 本身只是提示词,质量上限还是取决于底层模型。

无论如何,198k stars 说明很多人和 Matt 有同样的困惑:AI 写代码越来越快,但”怎么让它写对”越来越难。把工程纪律教给 agent,这个方向我认。

链接

2026年7月23日星期四

手机 tmux 客户端的网络接入之争

题图:Jordan Harrison via Unsplash

tmux-next 写完之后,顺手把市面上同类产品翻了一遍。发现这批工具真正在解决的,其实不是”画一个终端”,而是一个网络问题。

核心难题

你的机器在路由器后面,运营商多半还套了一层 CGNAT——它能主动往外连,但外面连不进来。手机在 4G/公司 WiFi/别人家,随时换网。要打通,无非四条路,这批 app 各选其一(或让你自选):

A · 公网反向代理——tmux-next(默认)用了这条。一个域名指向你的机器,前面放 Caddy/Nginx 终结 HTTPS 再转发到本地端口。要么你有公网 IP + 端口转发,要么反代本身再叠一层隧道(下面 C)。

B · 叠加网络 / 网状 VPN——Tmux Bridge 就是典型。手机和机器装进同一张虚拟网(WireGuard),之后像在同个局域网一样直接访问,不开任何入站端口,CGNAT 也穿得过去。

C · 出站隧道——Reattach 提供 Cloudflare Tunnel 选项。机器上跑个 cloudflared 守护进程,主动往云端拨一条常连的加密隧道,外部请求先到 Cloudflare 边缘,再顺着隧道推回机器。全程只有出站连接。

D · 直接 SSH——dotMux、Attach、NeoServer 都是这路。手机 SSH 进机器,拿到一个加密的 PTY 通道。但 SSH 端口得可达——所以现实里它常和 B/C/端口转发/跳板机叠着用。

关键洞察是这四条路不是互斥的,而是分层的:B、C 解决”够到”,A、D 解决”够到之后说什么话”。tmux-next 的反代完全可以架在 Cloudflare Tunnel 之上;dotMux 的 SSH 也常跑在 Tailscale 里。真正区分产品的,是它们把哪几层替你封好了。

三种”够到”的网络机制

Tailscale = WireGuard + 协调服务 + DERP 兜底。协调服务器只交换公钥,私钥永远不出设备。两端拿到对方信息后,用 STUN + 打洞尝试建直连 P2P(官方称九成以上能直连)。打不通时流量走 DERP 中继:它只在 443 上转发已经被 WireGuard 加密过的包,中继看不到明文。

Cloudflare Tunnel = cloudflared 出站拨号。机器上的守护进程向 Cloudflare 边缘拨出若干条 QUIC 长连接(往不同机房各一条,端口 7844),并一直保持。用户请求先打到 Cloudflare,再被顺着隧道推回机器。机器不监听任何公网端口,CGNAT 下照样能用。

反向代理 = 你自己终结 TLS。没有第三方叠加网时,就是经典打法:域名解析到你的机器,Caddy 监听 443、拿证书、验登录、转发到本地服务。tmux-next 正是如此。

够到之后:应用层协议

通道打通了,手机和 tmux 之间说什么话?目前两种。

裸 PTY:SSH 里直接 tmux attach,拿到一串终端字节流,本地用终端模拟器渲染。简单、通用,但手机拿到的只是一屏字符,没有窗口/pane 的结构信息。Attach、NeoServer 走这个路线。

tmux control mode:用 tmux -CC 打开控制模式。tmux 不再吐终端画面,而是一套结构化的行协议。发命令返回被 %begin / %end 包起来的输出块,还有以 % 打头的异步通知——%output、%window-add、%layout-change 等等。

拿到这套结构,用法就分野了:dotMux 把 %window-add / %layout-change 翻译成原生 iOS 的窗口和分屏;tmux-next 则主要用 %output 把字节喂给浏览器里的 xterm.js。同一套协议,一个驱动原生 UI,一个驱动网页终端。

tmux-next 的字节,端到端

手机端说的是 WebSocket,不是 SSH——这是 tmux-next 和那些原生 app 最根本的分岔。

1
浏览器 → WebSocket / 443 → Caddy(TLS + JWT 登录)→ 本地 Bun 服务 → control mode → tmux 会话

返回的方向同理:tmux 的 %output 被 Bun 解析后,通过同一条 WebSocket 把字节推给 xterm.js 渲染。手机只需要一个浏览器;SSH、control mode 这些都被关在服务端和本机之间,从不暴露给公网。

为什么是 WebSocket 而不是 SSH?因为客户端是”网页”。浏览器不能开 SSH 连接,但天生会说 WebSocket。代价是你得自己搭反向代理(TLS + 登录);回报是客户端零安装、跨设备,攻击面收敛成一个带登录的 HTTPS 端点,而不是一个对公网开放的 SSH/shell。

两个边角细节

TLS 证书:tmux-next 的 Caddy 用 DNS-01 校验,通过 Cloudflare 的 DNS 接口写一条 TXT 记录来证明域名归你,不必对公网开放 80 端口就能拿到 Let’s Encrypt 证书。适合藏在 NAT 后、端口能不开就不开的机器。

推送通知:原生 app 目前领先、tmux-next 还空白的一环。原生用 APNs,网页形态可以用 Web Push(VAPID)。把 tmux-next 加到主屏当 PWA 就能做,会话列表其实已经在判定活跃状态了(绿点排序),接上推送只是时间问题。

整理自:tmux Control-Mode wiki、Tailscale how-it-works、Cloudflare Tunnel 文档、dotMux 官网。

tmux-next:在手机上查看 tmux 会话

题图:Christian Wiediger via Unsplash

用 Claude Code 跑个长时间任务(重构、批量迁移之类的),然后人走开,过一会儿想在手机上看看跑完没有。以前的做法是跑回电脑前 tmux attach,或者 ssh 进去。有点烦。

tmux-next 就是在那个场景下写的。

做了什么

一个很小的 tmux 网页客户端。装好之后 bunx tmux-next 起一个服务,浏览器打开就能看到所有 tmux 会话。每个会话显示最后几行输出,Claude 打完一轮在等你回复时,那个会话会亮绿点并排到最前面,省得一个个点开看。

打开一个会话就是全屏的终端,手机键盘上没有的键(Esc、Ctrl、方向键)放在底部的工具条里。

最常用的场景

躺沙发上用手机看 Claude Code 的进度。不用再 ssh、不用开笔记本。扫一眼绿点就知道它还在等我还是正在跑。

代码托管在 GitHub,也发到了 npm。

关于安全

它自己没有登录,只绑在 localhost。想从手机访问得在前面放一个反向代理(比如 Caddy)做 HTTPS 和登录,不然等于把一个 shell 挂到公网上。项目首页有完整的 Caddy 部署指引,跟着配就行。